
Tesla ETL
ETL significa Extract, Transform, Load, ovvero estrazione, trasformazione e caricamento.
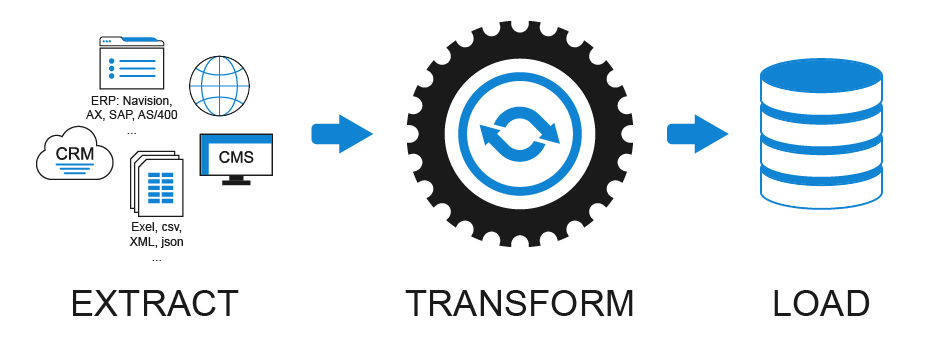
Tesla ETL raccoglie i dati da un numero potenzialmente illimitato di sorgenti, li elabora, trasforma e organizza per renderli disponibili nel formato richiesto dai sistemi che devono utilizzarli. I dati elaborati possono essere centralizzati in un unico repository oppure distribuiti verso più sistemi e destinazioni.
Perché trasformare i dati?
I software e i dispositivi aziendali necessitano di dati organizzati secondo formati e strutture precise, che raramente coincidono con quelli in cui le informazioni sono disponibili all’origine.
In quasi tutte le aziende i dati utili sono distribuiti tra applicazioni, database, file e sistemi differenti e sono normalmente strutturati per essere utilizzati dai software che li producono. Secondo alcuni studi, due terzi delle aziende non riescono a trarre pienamente beneficio dai propri dati proprio perché questi non sono immediatamente disponibili nella forma richiesta da altri processi.
Un sistema ETL rende queste informazioni utilizzabili: le estrae dalle diverse sorgenti, le ripulisce, le trasforma e le elabora per destinarle, per esempio, a sistemi di impaginazione automatica, siti Internet, applicazioni aziendali, macchine di produzione, sistemi di analisi e Data Warehouse.
AI ETL
Quando il processo deve anche decidere
Una pipeline ETL tradizionale è particolarmente efficace quando una trasformazione può essere descritta attraverso regole precise: calcoli, lookup, conversioni, vincoli, mapping, normalizzazioni e controlli deterministici.
Esistono però situazioni nelle quali non è sufficiente applicare una regola. Il sistema deve interpretare i dati, confrontare alternative oppure prendere una decisione che normalmente richiederebbe logiche euristiche o un intervento umano.
AI ETL aggiunge questo livello decisionale alla pipeline Tesla ETL.
Nel processo viene integrato Jev, un modello AI progettato non per generare genericamente contenuti, ma per prendere decisioni strutturate all’interno del software.
Jev riceve lo stato di un record o di un processo e restituisce un risultato utilizzabile direttamente dalla pipeline: una scelta tra alternative, un valore, un punteggio oppure una probabilità sì/no, accompagnati da un’indicazione di confidenza.
AI ETL non sostituisce quindi il processo ETL tradizionale. L’intelligenza artificiale viene inserita nei punti nei quali una regola deterministica non è sufficiente.
ETL per le regole, AI per le decisioni
A Tesla ETL competono le operazioni che possono essere definite attraverso regole precise: calcoli, lookup, conversioni, vincoli, mapping, normalizzazione e trasformazione dei dati.
A Jev vengono invece affidati gli “if difficili”: quelle decisioni nelle quali il software deve interpretare una situazione, scegliere tra alternative o valutare un risultato che non può essere ricavato efficacemente attraverso una semplice condizione deterministica.
Il workflow viene quindi scomposto in una sequenza di operazioni precise e decisioni circoscritte.
Il software tradizionale continua a eseguire tutto ciò che è deterministico. L’AI interviene soltanto dove è necessario decidere.
AI ETL nell’impaginazione automatica
L’impaginazione automatica di cataloghi e listini è uno degli ambiti nei quali l’integrazione tra regole ETL e decisioni AI può essere utilizzata in più punti dello stesso processo.
Classificazione dei prodotti
AI ETL può determinare categoria, sottocategoria o famiglia alla quale appartiene un prodotto sulla base delle informazioni disponibili.
Esempio:
Trapano X → elettroutensili / trapani
Controllo della qualità dei dati
Il sistema può valutare se le informazioni disponibili sono sufficienti per proseguire automaticamente oppure se un record deve essere sottoposto a verifica.
Esempio:
PUBBLICA / REVISIONE / BLOCCA
Entity matching
AI ETL può valutare se due record provenienti da sorgenti differenti rappresentano la stessa entità o lo stesso prodotto.
Esempio:
stesso prodotto: probabilità 0,94
Interpretazione degli attributi
Valori espressi in modi differenti possono essere ricondotti a una classificazione controllata.
Esempio:
“rosso rubino” → ROSSO
Routing delle trasformazioni
In base alle caratteristiche del record, AI ETL può decidere quale profilo di trasformazione o quale pipeline applicare.
Esempio:
ProfiloTrasformazione = ABBIGLIAMENTO
Decisioni editoriali
Il sistema può attribuire importanza o priorità ai contenuti che dovranno essere utilizzati nella pubblicazione.
Esempio:
priorità prodotto = 8/10
Preflight dell’impaginazione
Prima dell’impaginazione, AI ETL può valutare il rischio che i dati disponibili generino una pagina problematica e richiedere un controllo.
Esempio:
review_required = true, P=0,87
Utilizzo delle ETL
AI ETL amplia le possibilità della pipeline, ma Tesla ETL continua a essere utilizzato anche nei processi nei quali sono sufficienti trasformazioni completamente deterministiche.
Tra i principali casi d’uso:
- estrazione e organizzazione dei dati per sistemi di impaginazione automatica;
- integrazione dei sistemi informativi con le macchine di produzione;
- migrazione dei dati tra applicazioni differenti;
- acquisizione dei dati per l’esecuzione dei backup;
- estrazione da sistemi PDM e CRM, ottimizzazione e arricchimento delle informazioni e successiva restituzione dei dati agli stessi sistemi;
- alimentazione di Data Warehouse per l’assimilazione, l’ordinamento e la trasformazione delle informazioni destinate alle attività di Business Intelligence;
- migrazione delle applicazioni locali verso infrastrutture Cloud, Cloud ibride o multi-Cloud;
- sincronizzazione continua tra sistemi, software e dispositivi differenti;
- acquisizione continua dei dati destinati a statistiche e analisi.
Come funziona Tesla ETL
Un processo ETL è composto da tre fasi principali: estrazione, trasformazione e caricamento.
Fase 1: estrazione
I dati grezzi possono essere acquisiti da una vasta gamma di sorgenti:
- database come Oracle, SQL Server e MySQL;
- sistemi ERP come Navision, AX, SAP e AS/400;
- file strutturati come Excel, CSV, tab-delimited, XML e JSON;
- CMS come Liferay, Drupal, Magento, Prestashop e Argo;
- registri di attività, come traffico di rete e report di errore;
- eventi di sicurezza;
- attività transazionali;
- altre sorgenti previste dal progetto.
Fase 2: trasformazione
La trasformazione è la fase più critica di un processo ETL.
È qui che vengono applicate le procedure e le regole necessarie per ottenere il risultato richiesto. Prima di applicare queste regole, i dati vengono normalmente ripuliti e normalizzati: lavorare su informazioni incoerenti, incomplete o strutturate in modo differente rende infatti molto più complessa qualsiasi elaborazione successiva.
Durante la trasformazione vengono inoltre applicati i formati di uscita necessari ai sistemi di destinazione.
Le attività possono comprendere:
Normalizzazione
Definizione dei dati da prendere in considerazione e delle modalità con cui dovranno essere formattati e memorizzati.
Unificazione
Eliminazione delle duplicazioni e dei dati ridondanti e aggregazione delle informazioni equivalenti.
Verifica
Controlli automatici sulla correttezza e sulla qualità dei dati acquisiti ed elaborati.
Ordinamento
Preparazione delle informazioni secondo l’ordine necessario ai sistemi, software o dispositivi di destinazione.
Altre attività
Tutte le trasformazioni specifiche necessarie per raggiungere il risultato previsto dal progetto.
Con AI ETL, all’interno di questa stessa fase e negli altri punti della pipeline possono essere inserite anche decisioni Jev quando una trasformazione non può essere risolta efficacemente attraverso una regola deterministica.
Fase 3: caricamento
L’ultima fase consiste nella restituzione dei dati estratti e trasformati e, normalmente, nel loro caricamento nei sistemi, software, repository o dispositivi di destinazione.
Una stessa pipeline può quindi acquisire informazioni da più sorgenti e produrre uno o più output, ciascuno organizzato nel formato necessario al sistema che dovrà utilizzarlo.
Esecuzione operativa di Tesla ETL
Nella maggior parte dei casi Tesla ETL viene eseguito automaticamente attraverso uno schedulatore oppure richiamato da uno o più software appartenenti al sistema informativo aziendale.
Quando necessario, l’esecuzione può anche essere avviata manualmente da un operatore.
La progettazione della pipeline deve inoltre prevedere anomalie ed eccezioni che possono verificarsi durante l’acquisizione e l’elaborazione dei dati: sistemi temporaneamente non disponibili, informazioni mancanti, dati errati o di qualità insufficiente e altre condizioni che potrebbero compromettere il processo.
L’obiettivo è costruire un flusso capace non soltanto di trasformare correttamente i dati quando tutto funziona come previsto, ma anche di riconoscere e gestire le situazioni anomale definite durante la progettazione.